- 社内の「あの資料どこ?」が減らない原因は、AIが無いことではなく「答えが人の頭にしかない・文書はあるが探せる形になっていない・どれが最新版か分からない」の3つ。ここを直さずAIを入れても精度は出ません。
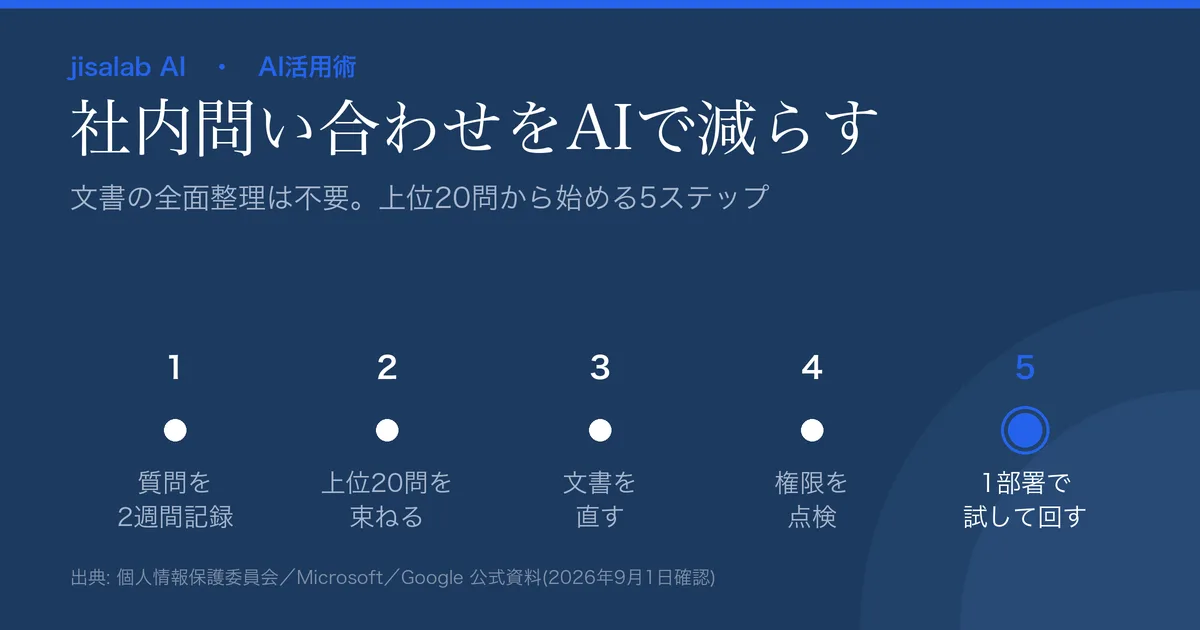
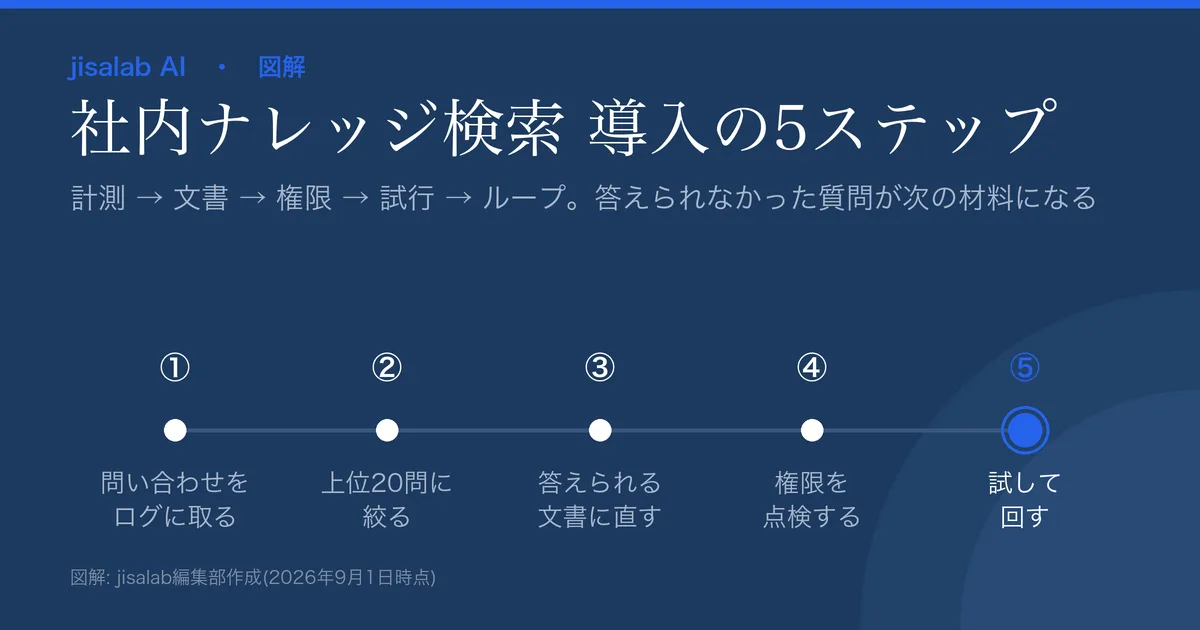
- 進め方は「①問い合わせを2週間ログに取る→②上位20問だけ答えを整える→③権限を先に片づける→④1部署で試す→⑤答えられなかった質問を回す」の5ステップ。全社の文書を一気に整理する必要はありません。
- ツールは「都度貼り付け型/グループウェア内蔵型/専用ナレッジ検索/自前構築」の4類型から選びます。文書がすでに1か所に集まっているかどうかが分岐点です。人事・給与など機微な情報は、入力してよい範囲を先に決めておきます。
「経費の締め日っていつでしたっけ」「あの契約書のひな形どこですか」——総務・情シス・経理に、同じ質問が毎日届く。答える側は手を止め、聞く側は返信を待つ。この記事は、社内の問い合わせを「AIが答えられる状態」に持っていく手順を、判定基準・プロンプト例・つまずきどころつきで解説します。対象は、社内からの問い合わせ対応に時間を取られている管理部門・情シス・チームリーダーの方です。
なお本記事は業務効率化の一般的な手順の解説です。個人情報や機微な情報をAIサービスに入力する際の可否は、契約プランや社内規程によって変わります。個別の判断は自社の規程・法務にご確認ください。
最終更新: 2026年9月1日/本文で参照した公式資料は同日に原文で確認しています。各ツールの機能・プラン名は変わるため、導入前に必ず各公式でご確認ください。金額・件数の例はすべて説明用で、自社の数字に置き換えて判断してください。
なぜ社内の「同じ質問」は減らないのか
社内問い合わせが減らない会社には、共通する型があります。マニュアルが無いのではなく、「あるのに使われない」のです。理由は次の3つに整理できます。
- 答えが人に紐づいている: 「この件は田中さんに聞けば早い」が定着している状態。田中さんが休むと業務が止まり、退職するとその答えごと消えます。
- 文書はあるが探せない: 共有ドライブに100ページのPDFがある。しかし「有給って何日前まで?」という質問語彙では、そのPDFにたどり着けません。
- 最新版が分からない: 「就業規則_最新_v3_修正版.docx」が並んでいる。どれが正か判断できないので、結局人に聞いて確認します。
時間コストを試算してみます(数値は例)。従業員50人の会社で、管理部門に届く社内問い合わせが1日20件、1件の回答に平均5分かかるとします。回答側だけで20件×5分×20営業日=月およそ33時間。ここに「聞く側が待っている時間」と「割り込みで集中が切れるコスト」が上乗せされます。しかもこの33時間は、新しい価値を1円も生んでいません。
ここで確かめるべきは、この時間のうちどれだけが「同じ質問の繰り返し」なのかです。繰り返しの割合が高ければ、全社の文書を整理しなくても、上位の質問だけ手当てすれば効果が出ます。ただしこの割合は会社によって違うため、推測せず次章の計測で自社の実数を出してください。本記事では便宜上「上位20問」と表記しますが、これは説明のための目安であって根拠のある定数ではありません。何問で足りるかは、あなたの会社のログが決めます。
先に決める:使うAIは4類型のどれか
「社内AI」と一括りにされがちですが、実態は次の4類型に分かれます。まず自社がどれを必要としているかを決めてください。
| 類型 | やり方 | 準備の重さ | 向く状況 |
|---|---|---|---|
| ①都度貼り付け型 | 汎用チャットAIに、その都度文書を貼って質問する | 軽い(即日) | まず効果を確かめたい。対象文書が数点 |
| ②グループウェア内蔵型 | 普段使うツール(ドキュメント・チャット)に付いているAI検索を有効にする | 中(数日〜数週) | すでに文書がそのツールに集まっている |
| ③専用ナレッジ検索 | 社内文書を読み込ませ、出典つきで回答させる専用サービスを使う | 中〜重い | 文書が複数の場所に散っている。出典表示が必須 |
| ④自前構築 | APIと検索基盤を組み合わせて自社で作る | 重い(開発体制が要る) | 独自の権限要件・既存システム連携がある |
準備の重さは文書量・権限設計・体制によって変わります。②③で要件が満たせる限りは、④に進む必要はありません。④は「②③では満たせない理由」を説明できるときだけ検討する、と考えると判断を誤りません。
選び方の判断基準はシンプルです。「文書がすでに1か所に集まっているか」で分岐します。ドキュメントもチャットも同じツールに集まっているなら②が最短で、追加の移行作業がほぼ不要です。一方、共有ドライブ・メール・チャット・紙のスキャンに散っているなら、まず集約が必要で、③の検討に入ります。
①はツール導入の前段として有効です。「その質問はAIで答えられるのか」を短期間で確かめられるため、稟議を通す前の検証に向きます。ただし毎回貼り付ける運用は続かないので、恒久策にはしません。
ステップ①:問い合わせを2週間ログに取る
いきなりマニュアル整備を始めると、「作ったが誰も読まない文書」が増えるだけに終わりがちです。順番を逆にします。実際に来た質問から、必要な文書を逆算します。
記録する項目は4つだけで十分です。専用ツールは要りません。表計算1枚で始めてください。
- 質問文(そのままの言葉で): 「有給の申請って何日前まで?」を「休暇取得手続について」と言い換えないこと。後でAIに検索させるとき、社員が使う言葉こそが検索語になります。
- 回答にかかった時間: 即答できたか、調べたか、他人に確認したか。
- 答えの在り処: 文書がある/人の頭の中/そもそも決まっていない、の3択。
- 質問者の部署: 特定部署に偏るなら、その部署向けの説明不足が原因かもしれません。
2週間分がたまったら、似た質問をまとめます。この作業自体もAIに任せられます。その前に一つだけ。AIに何を入力してよいかの線引きは後述しますが、この段階では「規程・手順書のような公開系の情報」と「個人名・取引先名を削った質問文」だけに留めてください。以下はそのまま使えるプロンプト例です。
- 以下は社内問い合わせの記録です。1) 同じことを聞いている質問をグループにまとめ、2) 各グループに「社員が実際に使いそうな言い方」の代表質問を1つ付け、3) 件数の多い順に並べ、4) 各グループについて「文書化すれば解決する / ルール自体を決める必要がある」のどちらかを判定してください。判定の理由も1行で。
—
(ここに質問ログを貼る)
ここで出てくる「ルール自体を決める必要がある」グループが重要です。これはAIでは解決しません。「そもそも決まっていないから毎回聞かれている」ものであり、AIを入れても答えは返りません。この切り分けを最初にやっておくと、後で「AIが使えない」という誤った結論を避けられます。
ステップ②:上位20問だけ「答えられる文書」に直す
社内AIの精度は、モデルの賢さより「読ませる文書の書かれ方」に左右されます。質問に関連する部分を文書から切り出し、それを根拠に回答を組み立てる方式(検索拡張生成、RAG)を採る製品では、文書全体ではなく切り出された断片が回答の材料になります。つまり、断片だけを読んで意味が通らない文書は、正しく答えられません。どの方式で動いているかは製品によって異なるため、検討中のツールがどう文書を読むのかは公式ドキュメントで確認してください。
この前提を踏まえると、既存文書に必要な直しは次の5点に絞れます。
| 直すこと | ダメな例 | 直した例 |
|---|---|---|
| タイトルを質問形にする | 経費精算マニュアル | 経費精算:いつまでに・誰に・何を出すか |
| 1文書1トピックに割る | 就業規則(全80ページ) | 有給の申請方法/慶弔休暇/時差出勤、に分割 |
| 結論を先頭に置く | 「当社では働き方改革の趣旨に鑑み…」から始まる | 「有給は取得日の3営業日前までに申請」から始まる |
| 更新日と担当を明記 | 日付なし・担当なし | 文書冒頭に「2026年4月1日改定/総務部」 |
| 例外を同じ文書内に書く | 原則だけ書き、例外は別ファイル | 「原則3営業日前。ただし急病の場合は当日連絡で可」 |
| 正本を1つに決める | 就業規則_最新_v3_修正版.docx が並ぶ | 正本を1つ決め、旧版は対象フォルダの外へ退避する |
最後の「正本を1つに決める」は、冒頭で挙げた原因③(どれが最新版か分からない)への直接の手当てです。旧版を消せない事情があるなら、対象フォルダから外に移すか、ファイル名の先頭に「【旧版】」を付けて区別できるようにします。AIに読ませる範囲に旧版を置かないことが要点です。もう1点、「例外を同じ文書内に書く」も見落とされがちです。原則と例外が別ファイルだと、AIは片方だけを拾って「原則」だけを答えてしまい、読んだ社員が例外に気づけません。ただし書きは必ず原則と同じ文書・同じ近さに置いてください。
既存文書の直しにもAIが使えます。文書の内容を書き換えさせるのではなく、構造の組み替えだけを頼むのがコツです。
- 以下の社内文書を、社員の質問に答えやすい形に組み替えてください。条件: 1) 記載されている事実・数値・条件は一切変更・追加しない、2) 想定される質問ごとに見出しを分け、見出しは社員が使う言い方にする、3) 各見出しの直後に結論を1〜2文で置く、4) 原則と例外はセットで同じ見出しの中に置く、5) 元文書に書かれていない事項は「元文書に記載なし」と明記する。
—
(ここに文書を貼る)
5)の指定は必ず入れてください。これが無いと、AIは一般論で穴を埋めます。「元文書に記載なし」と返ってきた項目こそ、実は社内で決まっていない論点であり、ステップ①で見つけた「ルールを決める必要がある」グループと突き合わせるべきものです。
元の文書が無い場合(答えが人の頭にしかないとき)
上位の質問のうち、ステップ①で「答えの在り処=人の頭の中」と記録したものには、直すべき元文書がありません。新しく書き起こす必要がありますが、白紙から作文するより速い方法が2つあります。
- 過去の回答をそのまま素材にする: 担当者は同じ質問に何度も答えているので、回答済みのメールやチャットが残っています。直近3件を集め、AIに「共通する回答の型を1本の文書にまとめ、3件で食い違っている点と、書かれていない条件は『要確認』と明記して」と頼めば、初稿になります。
- 15分のヒアリングを構造化する: 担当者に聞くのは2問だけで足ります。「その質問が来たら、何を確認して、どう判断しますか」「例外が出るのはどんなときですか」。この録音や書き起こしをAIで手順の形に整形します。
いずれも、公開前に担当者本人が事実確認をします。この工程は面倒に見えますが、属人化していた答えが文書になる瞬間でもあり、AI導入とは切り離しても価値が残ります。
もう一つ、日本の職場で詰まりやすいのが紙をスキャンしたPDFです。画像として保存されたPDFは文字データを持たないため、社内検索のインデックスに載らないことがあります。要約できるかどうかは、そのツールが画像の文字認識に対応しているかで変わります(汎用のチャットAIには画像を読めるものもあります)。対象にスキャン文書が含まれる場合は、OCR(文字認識)でテキスト化されているかを先に確認します。数が多ければ、頻出の質問に関係するものだけを優先してテキスト化すれば十分です。
ステップ③:権限を先に片づける
ここが最も見落とされ、最も事故につながる工程です。マイクロソフトとグーグルは、自社の企業向けサービスについて「そのユーザーが元から見られる範囲」に限って回答する設計を公式ドキュメントで公表しています。
マイクロソフトは Microsoft Copilot について、公式ドキュメントで「Microsoft Copilot only surfaces organizational data to which individual users have at least view permissions.(Copilotは、個々のユーザーが少なくとも閲覧権限を持つ組織データのみを提示する)」と述べ、続けて「It’s important that you’re using the permission models available in Microsoft 365 services, such as SharePoint, to help ensure the right users or groups have the right access to the right content within your organization.(組織内で適切なユーザーまたはグループが適切なコンテンツに適切なアクセス権を持つようにするため、SharePointなどMicrosoft 365で利用できる権限モデルを使っていることが重要です)」と、権限設計側の責任を明示しています。同ドキュメントは続けて「This includes permissions you give to users outside your organization through inter-tenant collaboration solutions, such as shared channels in Microsoft Teams.(これには、Microsoft Teamsの共有チャネルのようなテナント間のコラボレーション機能を通じて、組織外のユーザーに与えた権限も含まれます)」とも述べており、社外に出した権限も同じ射程だとしています。グーグルも Google Workspace の Gemini について「Gemini only retrieves relevant content in Workspace that the user has access to in order to contextualize the prompt and ground responses.(Geminiは、プロンプトに文脈を与え回答の根拠とするために、ユーザーがアクセス権を持つWorkspace内の関連コンテンツのみを取得する)」としています。
この保証が働くのは、AIがツール側の権限モデルを通して文書を読む場合だけです。上の2社は、いずれも②グループウェア内蔵型に当たります。①都度貼り付け型では、貼る人が見られる範囲がそのまま入力範囲になるため、権限による制御は働きません。③専用サービスと④自前構築は製品・設計によって異なるため、既存ツールの権限を引き継げるかを個別に確認する必要があります。
そのうえで押さえたいのが次の点です。権限モデルを通して読む構成では、AIは権限の壁を越えません。しかし、壁が最初から低ければ、AIはその低さを実務レベルで表に出します。これまでは「共有ドライブの奥に埋もれていて事実上誰も見なかった」ファイルが、質問一つで要約されて出てくるようになります。起きやすい事故は次の3つです。
- 全社共有フォルダに人事・給与関連の下書きが置かれている: 「来期の等級改定案.xlsx」が全社閲覧可のまま放置され、AIが内容を答えてしまう。
- 退職者・異動者のアクセス権が残っている: 権限の棚卸しが人事異動と連動していないと、本来外れているはずの人にも回答が届きます。
- 取引先との共有リンクが有効なまま: 期限なしの共有リンクが残っていると、社外の範囲まで巻き込みます。
対策は難しくありません。導入対象にする保管場所を1つに絞り、その場所だけ棚卸しすることです。全社の権限を完璧にしてから始めようとすると、いつまでも始まりません。「まず総務の共有フォルダだけ」と範囲を切り、次の順で手を動かします。
- 対象フォルダの共有設定を開き、公開範囲の一覧を出す: 主要なクラウドストレージの管理コンソールには、共有状態を一覧・レポートで確認する機能が用意されています。名称や場所は製品ごとに異なるため、自社が使う製品の管理者ヘルプで「共有レポート」「共有設定の確認」に相当する項目を探してください。
- 「リンクを知っている全員が閲覧可」になっている項目を抜き出す: この設定のファイルは、社内の誰でも、場合によっては社外からも開けます。意図的なものか、一度きりの共有が残ったものかを1件ずつ判定します。
- 閲覧メンバー一覧を在籍者名簿と突き合わせる: 退職者・異動者・社外ドメインのアカウントが残っていないかを確認します。ここは人事の名簿と照合するのが最短です。
- 機微な文書が混ざっていないかを目視する: 人事・給与・採用・法務の下書きが対象フォルダに入っていれば、AIに読ませる範囲から外すか、保管場所を移します。
3)のアカウント側の棚卸しは、入退社の手続きと一体で回すのが本筋です。具体的な進め方は入退社でSaaSアカウントを取りこぼさない手順で扱っています。
ステップ④⑤:1部署で試し、答えられなかった質問を回す
試行は小さく始めます。対象は1部署、期間は2〜4週間、質問は上位20問。このとき評価軸を「便利だったか」という感想にしないでください。次の3つで判定します。
- 出典を示せたか: どの文書のどこを根拠にしたかが表示されるか。出典が出ないなら、社員は結局確認のために人に聞きます。
- 知らないと言えたか: 文書に無いことを、もっともらしく作って答えていないか。ここが最重要の安全弁です。
- 質問の言い回しを変えても答えられたか: 「有給何日前」「休暇 申請 期限」など、社員の実際の言葉で試します。
回答時にも指示を添えると、推測での回答を抑えられます。社内向けの定型指示として配ってしまうのが実務的です。
- 以下の社内文書のみを根拠に回答してください。条件: 1) 回答の各文について、根拠にした文書名と該当箇所を示す、2) 文書に書かれていないことは推測せず「文書に記載がないため回答できません。総務部にご確認ください」と答える、3) 複数の文書で内容が食い違う場合は、両方を提示して更新日が新しい方を明示する、4) 一般的な法令や他社の慣行で補わない。
3)の指定が効きます。社内で「AIが嘘をついた」と報告される事例には、実際には古い文書を正しく引いているだけのものが混ざります。旧版と新版が両方残っていれば、AIはどちらを引いても間違いではありません。食い違いを表に出させることで、AIの精度問題ではなく文書の版管理問題だと切り分けられます。
そして答えられなかった質問こそが成果物です。試行期間中に「文書に記載がない」と返った質問を集め、ステップ②の直しに戻します。この往復を月1回まわすことで、答えられる範囲が広がっていきます。逆に、このループを設計せずに導入すると、初月の精度のまま止まり「やっぱり使えない」で終わります。
ツール候補と使い分け
類型が決まったら、具体的なツールの検討に移ります。それぞれの料金・機能の詳細は個別のレビュー記事に譲り、ここでは「社内の質問に答える」用途に絞った向き不向きだけ整理します。
| 状況 | 候補 | 理由 |
|---|---|---|
| 社内文書がドキュメントツールに集まっている | Notionなどのドキュメント基盤+内蔵AI | 文書とAIが同じ場所にあり、移行作業がほぼ不要 |
| やりとりの大半がチャットに埋もれている | Slackなどのチャット基盤+内蔵AI | 過去のやりとりが実質のナレッジになっている場合に有効 |
| まず効果を検証したい | ChatGPT/Geminiの法人プラン | 数点の文書で「答えられるか」を最短で確認できる |
| 文書が複数の場所に散っている/出典表示が必須 | ③専用ナレッジ検索サービス | 個別製品はjisalabで未検証のため名指しの推奨はしません。選定は下記4点で |
| 独自の権限要件・既存システム連携がある | ④自前構築 | ②③で要件が満たせない理由を説明できるときだけ。開発・保守の体制が前提 |
| 長文の規程・契約書を読ませたい | 長文読解の手順を併用 | 単発の読解は長文資料・PDFをAIで速く読む手順が近道 |
各ツールの料金・プラン・AI機能の範囲は変動します。導入前に必ず公式の料金ページと、リンク先の各レビュー(確認日は各記事に明記)をご確認ください。
③専用サービスを選ぶときの4点は次のとおりです。jisalabは実際に触っていない製品を名指しで推奨しない方針のため、ここでは製品名ではなく判断軸を示します。(A)回答に出典(どの文書のどこか)を必ず表示できるか (B)既存ツールの権限をそのまま引き継げるか(引き継げないものは、権限管理が二重になります) (C)日本語の表記ゆれに耐えるか(実際の社内用語で試す) (D)文書とログの保存先・学習利用の扱いが契約で確認できるか。この4点は、必ず自社の実文書で試用してから判断します。
費用は「追加料金」と「削減できる時間」の両建てで見ます。判断式は〈月間の問い合わせ対応時間 × 削減できる割合 × 人件費の時間単価〉と〈AIの月額 × 対象人数〉の比較です。両辺を実際に置いてみます(数値はすべて例)。
- 効果側: 冒頭の例(管理部門の対応が月33時間)で、時間単価3,000円・削減率3割と置くと、33×0.3×3,000=月およそ3万円。
- 費用側: 1人あたり月3,000円のプランを従業員50人全員に配ると、月15万円。
この例では費用が効果を大きく上回ります。これは失敗例ではなく、比較の単位がずれていることを示しています。削減されるのは「回答する側(管理部門の数名)」の時間なのに、ライセンスは「質問する側」も含めた全員分を数えているためです。ずれを直す道は2つあります。
- 対象を絞る: まず管理部門と、質問が集中する部署だけに配る。10人なら月3万円まで下がります。ただし効果側も見直しが要ります。削減が「回答者の調べる時間が縮む」ことで起きるなら、管理部門に配るだけで効果はおおむね残ります。「質問者が自分で解決する」ことで起きるなら、配らなかった人の分だけ効果を割り引いて見積もってください。どちらの経路で効くかは、ステップ①のログで「回答に調べる時間がかかった質問」がどれだけあるかを見ると当たりが付きます。
- 効果を合算する: 全員に配るなら、社内問い合わせの削減だけで正当化しようとせず、文書作成・要約・翻訳など他の用途の効果も同じ表に載せます。問い合わせ削減は「複数ある効果の1つ」として扱うほうが実態に合います。
さらに、見積もりから漏れやすいのが利用料以外のコストです。ステップ②の文書整理、ステップ③の権限棚卸し、そして運用ループの手間は、いずれも自社の工数として発生します。稟議ではライセンス費だけでなく、この工数と担当者を明記しておくと、後で計画が崩れません。
導入時の注意点:入力してよい情報の線引き
社内ナレッジには、就業規則のような公開前提の文書だけでなく、人事評価・健康情報・顧客情報が混ざりがちです。個人情報保護委員会は令和5年6月2日の「生成AIサービスの利用に関する注意喚起等」で、個人情報取扱事業者における注意点として次の2点を挙げています(別添1(1))。
- ① 個人情報取扱事業者が生成AIサービスに個人情報を含むプロンプトを入力する場合には、特定された当該個人情報の利用目的を達成するために必要な範囲内であることを十分に確認すること。
- ② 個人情報取扱事業者が、あらかじめ本人の同意を得ることなく生成AIサービスに個人データを含むプロンプトを入力し、当該個人データが当該プロンプトに対する応答結果の出力以外の目的で取り扱われる場合、当該個人情報取扱事業者は個人情報保護法の規定に違反することとなる可能性がある。そのため、このようなプロンプトの入力を行う場合には、当該生成AIサービスを提供する事業者が、当該個人データを機械学習に利用しないこと等を十分に確認すること。
この①と②は対象が違います。①は「個人情報」、②は「個人データ」で、②のほうが対象が狭くなります。個人情報保護法第16条第3項は「この章において「個人データ」とは、個人情報データベース等を構成する個人情報をいう」と定め、その「個人情報データベース等」を同条第1項第1号で「特定の個人情報を電子計算機を用いて検索することができるように体系的に構成したもの」等としています。どこから②の確認義務がかかるかの判断に効くので、自社で線引きを作るときは条文の語をそのまま使ってください。
なお同委員会は、この注意喚起について「今後、追加の注意喚起等を実施する可能性もある点に留意されたい」としています。参照するときは最新の公表資料を確認してください。
実務では、この②が「法人プランを使う理由」に直結します。マイクロソフトとグーグルは、それぞれ学習利用の扱いを公式ドキュメントで公表しています。マイクロソフトは「Prompts, responses, and data accessed through Microsoft Graph aren’t used to train foundation LLMs, including those used by Microsoft Copilot.(プロンプト・応答・Microsoft Graph経由でアクセスされたデータは、Microsoft Copilotが使用するものを含め、基盤LLMの学習には使われない)」と明記しています。グーグルも Workspace について「Workspace does not use customer data for training models without customer’s prior permission or instruction(顧客の事前の許可または指示なく、モデルの学習に顧客データを使用しない)」としています。ただし、この記述の射程は「基盤LLMの学習」です。マイクロソフトの同ドキュメントには、任意で送るフィードバックはCopilotの改善に用いることがある(ただし基盤LLMの学習には使わない)という別の記述もあります。「学習利用が一切ない」と読まず、何に使われないと書かれているのかを条文単位で確認するのが実務的です。また、これらはいずれも法人向けの契約・プランに紐づく条件で、無料版・個人向けプランでは扱いが異なることがあります。自社が契約しているプランの条件を必ず確認してください。
そのうえで、社内向けには3段階の線引きを先に決めておくと運用が楽になります。第1層=公開系(規程・手順書・FAQ)は無条件で読ませてよい、第2層=業務データ(取引先名・金額)は承認済みの法人プランに限る、第3層=人事評価・健康情報・採用の応募書類などは原則入れない。判断に迷う情報が出たときは、第3層に倒してから相談する運用にします。より詳しい社内ルールの作り方は生成AIの社内利用ルールを作る手順で解説しています。
日本の職場での勘所
日本の中小〜中堅企業でこの取り組みを進めるとき、固有のつまずきがいくつかあります。まず「文書化されていない配慮」の多さです。「この申請は形式上は部長決裁だが、実際には先に現場に一声かける」といった運用が、規程ではなく慣行として存在します。AIは規程しか読めないため、規程どおりの答えを返し、それが現場感覚とずれます。対策は、AIに慣行を教え込むことではなく、ずれが出た質問を「規程と運用が乖離している論点」として拾い上げることです。むしろ棚卸しの好機になります。
次に稟議と体制の問題です。情シス専任がいない会社では、この取り組みが総務や管理部門の「片手間」になりがちです。しかしステップ①の計測とステップ②の文書直しは、実はその仕事を一番よく知っている担当者にしかできません。逆に言えば、外部に丸投げできない代わりに、外注費をかけずに最も効く部分を自社で進められるということでもあります。稟議では「ツール費用」ではなく、冒頭で試算した「月◯時間の問い合わせ対応」を自社の数字で示すのが通りやすい説明です。
最後に言葉の揺れです。日本語の社内文書は「経費精算」「立替精算」「精算申請」のように、同じ手続きが複数の呼び名を持ちがちです。さらに漢字・ひらがな・カタカナ・英略語が混在します。ステップ①で「社員が実際に使った言い方」をそのまま記録するよう強調したのは、この揺れを吸収するためです。文書のタイトルや見出しに、社員が使う呼び名を併記しておくと、検索でたどり着ける確率が上がります。
次に取るべき行動
- □ 今日から2週間、届いた社内問い合わせを「そのままの言葉」で表計算に記録する
- □ 質問をグループにまとめ、「文書化で解決する/ルールを決める必要がある」に切り分ける
- □ 頻出の質問に対応する文書を、質問形タイトル・結論先頭・原則と例外セット・更新日明記に直す(件数はログ次第)
- □ 同じ規程の旧版が複数残っていないか確認し、正本を1つ決めて旧版を対象フォルダの外へ退避する
- □ 対象にする保管場所を1つに絞り、機微な文書の混入・全社公開設定・期限なし外部共有を点検する
- □ 入力してよい情報の3段階(公開系/業務データ/原則入れない)を決めて共有する
- □ 1部署・2〜4週間で試し、「出典を示せたか」「知らないと言えたか」で評価する
- □ 答えられなかった質問を月1回集め、文書の直しに戻すループを定例化する
よくある質問(FAQ)
文書がほとんど整っていません。それでも始められますか?
始められます。むしろ文書が無い会社ほど、この手順の効果が大きく出ます。ポイントは、整備してから計測するのではなく計測してから整備することです。2週間のログで頻出の質問が見えれば、必要なのは質問1つにつきA4半ページ程度の文書です。80ページの規程を作る話ではありません。何本必要かはログの結果次第なので、先に計測してください。なお「答えが決まっていない」質問が多く出てきた場合、それはAI導入の課題ではなく業務ルールの課題なので、先にそちらを決めてください。
AIが間違った答えを返しました。使うのをやめるべきですか?
やめる前に、間違いの種類を切り分けてください。典型的なのは次の2つです。1つは「古い文書を正しく引いている」ケースで、これはAIの問題ではなく版管理の問題です。もう1つは「文書に無いことを推測で埋めた」ケースで、これは回答時の指示で「記載がなければ回答できませんと答える」と明示することで抑えられます。この2つを除いても誤りが残る場合に、初めてツールや構成の見直しを検討してください。いずれにせよ、社内規程や契約に関わる回答は、重要な判断の前に原本で確認する運用を残してください。
無料版のAIを社内で使うのはだめですか?
一律にだめということではなく、確認すべきことが増えると考えてください。個人情報保護委員会は、本人の同意なく個人データを含むプロンプトを入力する場合について「このようなプロンプトの入力を行う場合には、当該生成AIサービスを提供する事業者が、当該個人データを機械学習に利用しないこと等を十分に確認すること」を求めています。その確認が無料版で取れるなら使えますし、取れないなら個人データを含む入力はしない、というのが線引きです。加えて実務では、誰が何を入力したかを管理者側で把握できるかどうかも、法人向けプランとの差になりやすい点です。本文の第1層(規程・手順書・FAQ)だけを対象にするなら、無料版のまま検証を始めることはできます。範囲を広げる前にプランを見直す、という順序が現実的です。
社員が「聞いたほうが早い」と言って使ってくれません。
精度より先に導線を疑ってください。普段使っていないツールを開かせる設計だと、チャットで人に聞くほうが速いのは事実です。対策は、普段いる場所(社内チャットなど)から質問できるようにすること、そして回答する側が「その質問はこちらで聞けます」と誘導を徹底することです。あわせて、答えられなかった質問を回収して文書を足すループが回っていれば、使えば使うほど答えられる範囲が広がり、体感が変わります。逆にループが無いと、初期の失敗体験だけが記憶に残って定着しません。
あわせて読みたい
入力してよい情報の線引きを社内規程に落とすなら → 生成AIの社内利用ルールを作る手順
整備したデータが効果につながっているかを測るなら → 生成AIの効果が「効率化」で止まる理由と、次の一段に上がる手順
出典・参考
- 個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」(令和5年6月2日)別添1「生成AIサービスの利用に関する注意喚起等」(1)個人情報取扱事業者における注意点 ①②|個人情報保護委員会(2026年9月1日に原文PDFで確認)
- Microsoft「Data, Privacy, and Security for Microsoft Copilot」(ms.date 2026-07-09/更新 2026-08-18)|Microsoft Learn(2026年9月1日確認)
- 個人情報の保護に関する法律(平成15年法律第57号)第16条第1項第1号・第3項(個人情報データベース等/個人データの定義)|e-Gov法令検索(2026年9月1日にe-Gov法令APIで条文取得)
- Google「Generative AI in Google Workspace Privacy Hub」|Google Workspace 管理者ヘルプ(2026年9月1日確認)
本記事は業務効率化の一般的な手順の解説です。個人情報の取扱いに関する個別の適法性判断は、自社の規程および弁護士等の専門家にご確認ください。
本記事に登場する製品名・ロゴは各社の商標または登録商標です。掲載の図解はjisalab編集部が作成したものです。英文の公式資料は原文と編集部訳を併記しています。