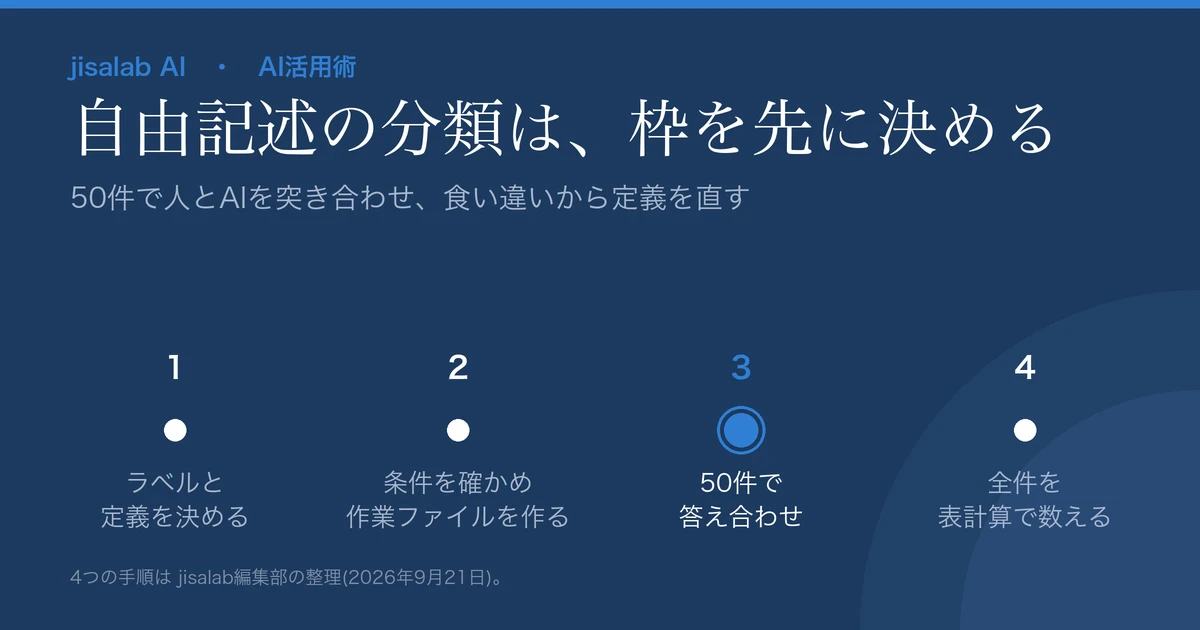
- 分類の枠(ラベル)と1行の定義は人が先に決めて固定します。枠までAIに任せると、前回と件数を比べられません。
- 全件を流す前に50件で答え合わせをします。食い違いが特定の組み合わせに集中していれば、AIの誤りより定義の穴を疑います。
- IDを振った作業ファイルで件数を表計算で数え、4つの検算がすべて0になってから資料にします。
この記事では、アンケートや問い合わせの自由記述をAIで分類し、件数として報告できる形にするまでを、1つの作業ファイルの上で順にたどります。対象は集計を任された企画・マーケティング・カスタマーサポート・人事の方で、プログラミングの知識は前提にしません。
最終更新: 2026年9月21日/引用した法令・公的資料・各社公式ページは、同日に原文を取得して確認しています。手順・指示文・式・件数・所要時間の例は編集部が作成・仮定したもので、実測ではありません。法令に触れる部分は一般的な解説で、自社のデータの扱いは社内規程の担当部署や弁護士等の専門家にご確認ください。
「分類して」とだけ頼むと、なぜ集計に使えないのか
自由記述を貼り付けて「分類して」と頼めば、それらしい結果は返ってきます。ただ、枠を指定していなければ、次のようなことが起こり得ます。
- 枠が回ごとに変わる: 1回目は「価格/機能/サポート」、2回目は「料金が高い/使い方が難しい/対応が遅い」。
- 表記がゆれる: 「価格」「料金」「コスト」が別の枠として数えられ、実際より分散して見えます。
4つの手順と作業ファイル
先に列の割り当てを決めておくと、手順③と手順④で同じ式・同じ貼り付け方をそのまま使い回せます。
| 列 | 中身 | 入れ方 |
|---|---|---|
| A | ID | ID付きの複製から値で貼る(手順②) |
| B | 自由記述 | 同上(手順②) |
| C | AIに送る文字列 | 式(手順②) |
| D | 人の分類 | 手で入力(答え合わせのシートのみ) |
| E | AIの分類 | 式でIDから引く(手順③) |
| F | 一致/食い違い | 式(答え合わせのシートのみ) |
| H〜J | AIの返答の貼り付け場所 | 貼り付けて列に分割(手順③) |
1行目はすべての列を見出しにします(H1「返答ID」、I1「返答ラベル」、J1「3列目」など)。G列は2人目の分類用、K列は乱数の作業用に空けておきます。M列から右は手順③のクロス表と検算に使います。
手順① ラベルと定義を決める
何を知りたいのかから逆算して、分類の枠を「その他」を含めて5〜7個書き出します。「その他」が無いと、どの枠にも当てはまらない意見が近そうな枠へ押し込まれます。
各ラベルには1行の定義を添えます。定義は手順③で直します。1件に付けるラベルは、この記事では1つとします。決めたラベルと定義は次の指示文に入れ、手順③でも手順④でも同じ指示文を使います。
以下の「回答」を、下のラベルのいずれか1つに分類してください。

【ラベルと定義】
価格 … 金額そのものへの言及
機能 … 機能の不足・使いにくさ
サポート … 問い合わせ対応・説明・マニュアルへの言及
納期 … 届くまでの時間・スケジュールへの言及
その他 … 上のどれにも当てはまらないもの

【ルール】
- 1件につきラベルは1つだけ
- 上の5つ以外のラベルを作らない
- ラベル名は【ラベルと定義】の文字列を一字一句そのまま使う(かっこ書きや補足を付けない)
- 出力はコードブロック1つの中に「ID,ラベル」の行だけ。見出し行・説明・前置きは書かない

【回答】
1,配送が遅くて困りました
2,値段のわりに機能が少ないと感じます
3,担当の方の説明が丁寧でした
返ってくるのは 1,納期 2,機能 3,サポート のような行です。【回答】の下に貼る行は、手順②で作るC列からコピーします。
手順② 送る前に条件を確かめ、作業ファイルを作る
個人情報保護委員会は「生成AIサービスの利用に関する注意喚起等」(令和5年6月2日)で、個人情報取扱事業者向けの注意点を2つ挙げています。1点目は「個人情報取扱事業者が生成AIサービスに個人情報を含むプロンプトを入力する場合には、特定された当該個人情報の利用目的を達成するために必要な範囲内であることを十分に確認すること。」、2点目は次のとおりです。
「個人情報取扱事業者が、あらかじめ本人の同意を得ることなく生成AIサービスに個人データを含むプロンプトを入力し、当該個人データが当該プロンプトに対する応答結果の出力以外の目的で取り扱われる場合、当該個人情報取扱事業者は個人情報保護法の規定に違反することとなる可能性がある。そのため、このようなプロンプトの入力を行う場合には、当該生成AIサービスを提供する事業者が、当該個人データを機械学習に利用しないこと等を十分に確認すること。」
「個人情報取扱事業者」は、個人情報保護法第16条第2項で「個人情報データベース等を事業の用に供している者」と定められています(ただし書きで国の機関・地方公共団体・独立行政法人等・地方独立行政法人を除く)。顧客名簿や回答一覧を業務で使っていれば、中小企業も該当し得ます。
サービス側の条件の例として、OpenAIの「エンタープライズプライバシー」ページは、顧客企業のビジネスデータについて「デフォルトでは、お客様のビジネスデータをモデルの学習に使用することはありません。サービス向上のために、お客様がデータ共有に明示的に同意した場合(フィードバック機能を通じた共有など)、共有されたデータをモデルの学習に使用することがあります。」と書き、別の回答では「個人利用の ChatGPT およびその他のサービスの各バージョンからのデータも使います」としています。同ページには、プランごとのデータの保持期間と、会話を見ることができる人についての回答もあります。Google(Google Workspace)とAnthropic(商用製品)も、入力を学習に使うかどうかを公式ページで説明しています。
| 確認点 | 根拠 | 確かめ方(編集部の推奨) |
|---|---|---|
| 利用目的の範囲 | 注意喚起の1点目 | 自由記述の分類が、自社で特定した利用目的を達成するために必要な範囲内かを、社内規程の担当部署に確かめる |
| 学習に使うか | 注意喚起の2点目 | 会社が契約した業務向けプランか個人の契約かを契約画面で確かめ、フィードバック送信など学習への利用に同意する操作を社内で認めるかを決める(プランの違いはChatGPTのレビュー記事) |
| 保持と閲覧 | なし(編集部が加えた確認点) | 入力が保存される期間と、見ることができる人を公式ページで確かめる |
なお、IDで元のファイルに戻せる以上、列を外しても「個人データではなくなった」とは言い切れません。社内での位置づけは生成AIの社内利用ルールを作る手順にまとめています。
確かめたら作業ファイルを作ります。元のファイルを複製し、A列の前に列を1つ挿入してIDを振ります(1と2を入力して下へ引き伸ばす。元のA列の日時などを上書きしないため)。このID付きの複製が、元データとの対応表になります。作業ファイルの「全件」シートには、ID列と自由記述の列だけを値として貼り、次の2つを片付けます。
- 空欄と「特になし」: B列で並べ替えると、空の行は末尾に、同じ文字列の回答は隣り合って並びます。空の行と「特になし」「なし」だけの行を削除し、それぞれの件数を控えます(IDは行と一緒に動くので、元の順に戻す必要はありません)。
- 本文中の個人情報: 氏名や電話番号が書き込まれていることがあるため、「様」「@」「電話」などで検索して伏せ字にします。Googleスプレッドシートでは「検索と置換」で「正規表現を使用した検索」を選び、
[0-90-9]{4}と入れると4桁以上の数字の並びも探せます。このとき検索範囲はB列だけに絞ります(「特定の範囲」でB列を指定)。シート全体で置換すると、A列のIDまで伏せ字になり、元データと突き合わせられなくなります。
最後に、C列にAIへ送る文字列を作ります。
C2: =A2&","&SUBSTITUTE(CLEAN(SUBSTITUTE(B2,CHAR(10)," ")),",","、") ← 最終行までコピー
改行と制御文字を消し、半角カンマを読点に替えるのは、IDと本文を区切るカンマが本文中のカンマと紛れないようにするためです。
手順③ 50件で答え合わせをして、定義を直す
全件を流す前に、50件だけでAIの選び方と人の判断を突き合わせます。50件は人が一度に分類しきれる量(1件30秒で25分)として置いた数で、統計的な根拠はありません。定義の穴を探すための数で、一致率を正確に測る標本としては小さい点に注意してください。
③-1 50件を選ぶ
1) 「全件」シートを複製し、「答え合わせ」シートにする
2) K2に =RAND() を入れ、最終行までコピーする
3) K列をコピーし、同じ場所に値として貼り付ける(RANDは再計算のたびに変わるため)
4) 2行目から最終行までのA〜K列を選び、K列の順に並べ替える
5) K列を消す。1周目は上から50件(2〜51行目)を使う
③-2 人が先に分類する
B列を読み、D列にラベルを入れます。D列をプルダウン(Excelは「データの入力規則」、Googleスプレッドシートは「挿入」→「プルダウン」)にすると打ち間違いを防げます。AIの結果を見る前に終えるのは、人の判断をAIの結果から独立させておくためです。
できれば2人で行います。2人目はD列を非表示にしてからG列に分類し、=SUMPRODUCT((D2:D51<>G2:G51)*1) で人どうしの食い違いを数えます。人でも割れる場所は、定義の穴のいちばんの候補です。
③-3 AIに送り、返答を戻して検算する
指示文の例の3行(1,配送が…)を消してから、【回答】の下にC2〜C51を貼って送り、返ってきた行をH2に貼ります。貼った範囲を選び、Excelは「データ」→「区切り位置」、Googleスプレッドシートは「データ」→「テキストを列に分割」で、区切り文字にカンマを選びます。H列にID、I列にラベルが入ります(Excelでは、一度区切り位置を使うと、次からの貼り付けで自動的に列に分かれることがあります。その場合、分割は要りません)。続けて、次の式を入れます。
E2: =IFERROR(VLOOKUP(A2,$H:$I,2,FALSE),"未返却")   ← 51行目までコピー
F2: =IF(D2=E2,"一致","食い違い")                     ← 51行目までコピー

クロス表(M2〜M6に人のラベル、N1〜R1にAIのラベルを、指示文と同じ順に並べる)
N2: =COUNTIFS($D$2:$D$51,$M2,$E$2:$E$51,N$1)        ← R6までコピー

検算(M10〜M13に名前、N10〜N13に式。-1 は見出し行の分)
M10: 未返却          N10: =COUNTIF(E2:E51,"未返却")
M11: 指定外のラベル  N11: =50-SUM(N2:R6)-N10
M12: 余分な行        N12: =COUNTA($H:$H)-1-(50-N10)
M13: 3列目あり       N13: =COUNTA($J:$J)-1
E列はIDで返答を引くので、行の順番が変わってもずれません。4つの検算がすべて0になってから、クロス表を読みます。0でなければ次の表のとおりに直します。
| 検算 | 主な原因 | 直し方 |
|---|---|---|
| 未返却 | AIが行を飛ばした | E列で「未返却」を絞り込み、そのIDだけ送り直して、返答をH列の最終行の下に貼る |
| 指定外のラベル | 「価格(配送関連)」のような補足付き、前後の空白付き、定義に無いラベル名 | H〜J列の該当行を消し、そのIDだけ送り直す |
| 余分な行 | 同じ範囲の二重貼り付け、見出し行や前置きの文の貼り込み | H〜J列から余分な行を消す |
| 3列目あり | 1件に2つのラベル。I列のラベルだけが数えられるため「指定外のラベル」では見つからない | H〜J列の該当行を消し、そのIDだけ送り直す |
手順③の「指定外のラベル」の式は、D列がすべてプルダウンのラベルで埋まっている前提です。
③-4 クロス表で食い違いを読む
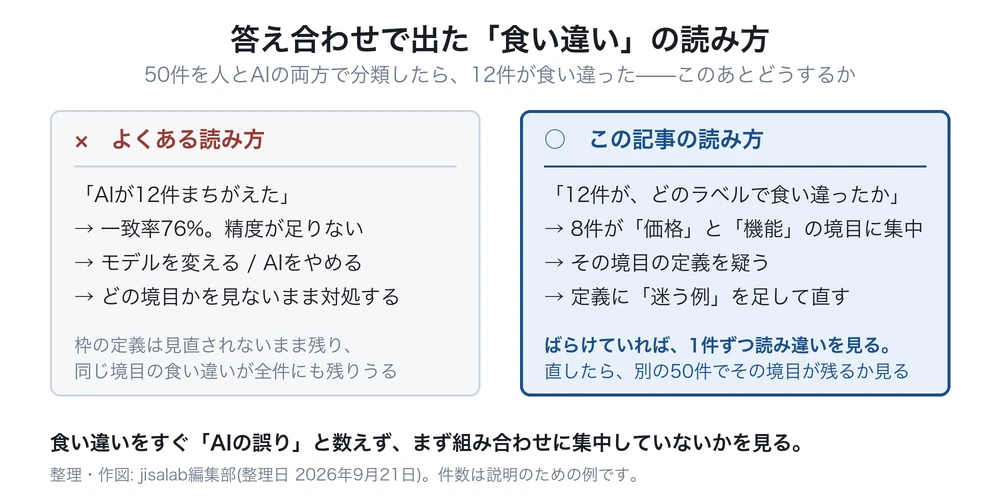
対角線(人とAIが同じラベル)以外のマスが食い違いです。食い違いはすぐに「AIの誤り」と数えず、特定のマスに集中していないかを見ます。たとえば12件が食い違い、うち8件が「人が価格・AIが機能」のマスに集まっていたら、一致率76%を低いと見てモデルを変えるより、「価格」と「機能」の境目の定義を疑い、迷う例を1行足します。どちらのラベルに寄せるかは、業務の目的で決めます。ばらけていれば、F列で「食い違い」を絞り込み、読み違いとして1件ずつ見ます。
直す前) 機能 … 機能の不足・使いにくさ
直した後) 機能 … 機能の不足・使いにくさ。「価格に見合う価値がない」はこちら
ラベルが6〜7個のときは、M列とN1から右に並べるラベルを増やし、N2の式をその範囲の右下までコピーして、N11のSUMの範囲も合わせます(7個ならM2〜M8、N1〜T1、SUM(N2:T8))。
③-5 別の50件で確かめる
直した定義を指示文にも入れ、次の50件で2周目を行います。「答え合わせ」シートを複製して「2周目」とし、52〜101行目のA〜B列を2行目に値で貼り、D・G・H〜J列の2行目以降を消します(式はそのまま使えます)。人も直した定義で先にD列を分類し、直した指示文で送ります。
判断の基準は、直した境目のマスの食い違いがほぼ無くなったかです。食い違いの総数は参考にとどめます。境目に当たる回答が少なければ、「全件」シートを境目の語(例:「値段」「割高」)で検索して数件を足し、人とAIの両方で分類します。足した分は2周目の式(50件固定)には数えられないので、E列・F列と同じ式を別の行に置いて一致か食い違いかを目で数え、クロス表とは別に記録します。残っていれば定義を直して次の50件で繰り返し、何度直しても残るラベルは統合するか、捨ててその回答を「その他」に入れます。
手順④ 全件を分類し、表計算で数える
定義が固まったら、「全件」シートで同じことを全件に行います。
- 分けて送る: C列を100件ずつ(C2〜C101、C102〜C201…)、毎回新しい会話で送ります。
- 続けて貼る: 2回目以降の返答はH列の最終行のすぐ下に貼り、その回に貼った範囲だけを列に分割します。
- E列に同じ式: 手順③のE2の式を、最終行までコピーします。D列とF列は使いません。
数えるのは別の「集計」シートです。件数をAIに数えさせないのは、式が残り、誰が開いても同じ数を出し直せるからです。
A2〜A6: 価格 / 機能 / サポート / 納期 / その他(7個ならA8まで)
B2: =COUNTIF('全件'!$E:$E,A2)            ← ラベルのある行までコピー

検算(A列に名前、B列に式。-1 は見出し行の分)
A10: 回答件数        B10: =COUNTA('全件'!$A:$A)-1
A11: 未返却          B11: =COUNTIF('全件'!$E:$E,"未返却")
A12: 指定外のラベル  B12: =B10-SUM($B$2:$B$8)-B11
A13: 余分な行        B13: =COUNTA('全件'!$H:$H)-1-(B10-B11)
A14: 3列目あり       B14: =COUNTA('全件'!$J:$J)-1
資料にするのは、B11〜B14の4つがすべて0になってからです。0でないときは、手順③-3の表のとおりに直します。
4つの検算で見つかるのは形の崩れだけで、正しい形のまま誤ったラベルが付いた行は見つかりません。そこで最後に抜き取り点検をします。手順③-1と同じ乱数の並べ替えをしてから、E列でラベルごとに絞り込み、上から10件(10件未満のラベルは全件)のB列の原文を読んでラベルが妥当かを見ます。報告書の「代表的な声」も、AIの要約ではなくB列の原文からコピーします。出力の確かめ方はAIの答えを業務で使う前の検証手順、表計算の操作はExcel/スプレッドシート作業をAIで速くする手順で扱っています。
どこに時間がかかるのか(試算)
| 工程 | 人手で分類する場合 | この記事の手順 |
|---|---|---|
| ラベルと定義を決める | 30分 | 30分 |
| 作業ファイルの準備 | なし | 15分 |
| 分類する | 800件×30秒=400分 | AIが処理 |
| 答え合わせ(50件を人が分類) | なし | 50件×30秒=25分 |
| 食い違いを読み、定義を直す | なし | 30分 |
| 2周目(別の50件で確認) | なし | 50件×30秒+10分=35分 |
| AIとの受け渡し | なし | 10往復×5分=50分 |
| 抜き取り点検(ラベルごとに最大10件) | なし | 最大50件×30秒=25分 |
| 集計・資料化 | 30分 | 30分 |
| 合計(目安) | 約7時間40分 | 約4時間 |
仮定(編集部が置いた値): 人が1件を分類するのに30秒/受け渡しは、50件を2回(1周目・2周目)と100件を8回の計10往復で、1往復(貼り付け・列の分割・検算の確認)5分/AIの処理待ちの時間は含めない。
日本の読者にとっての意味
日本の職場でこの手順を使うとき、先に決めておきたい点が2つあります。
1つ目は「特になし」の扱いです。自由記述欄を必須にしたアンケートでは、「特になし」「なし」「とくにありません」のような回答が入ることがあります。この記事の指示文の定義では、これらは「その他」に入るため、「その他」が実際より大きく見えます。この記事は手順②で削除して件数を控えましたが、「回答なし」のラベルを立てて数える方法もあります。どちらにするかは報告の目的で決め、次回も同じ扱いにそろえます。
2つ目は報告のしかたです。集計結果には「この数字はどう出したのか」と聞かれることがあります。資料の脚注には、たとえば「有効回答○件(空欄○件・「特になし」等○件を除く)。分類は生成AIで実施(指示文は別紙)。ラベルの定義は無作為に選んだ50件ずつ2回、人の分類と突き合わせて修正・確認。件数は表計算で集計し、4つの検算がすべて0であることを確認」と書きます。集計シートの式と検算の数字を残しておけば、根拠はその場で示せます。
つまずきやすい点
- 「その他」が1位になる: 「その他」の中身を読み、新しい枠を1つ立てて手順③からやり直します。
- 全件の途中で定義を直す: 直す前と後の基準が1つの集計に混ざるため、それまでに送った分も送り直します。
- 指示文を人によって書き換える: 指示文は1本に固定して共有します。方法はプロンプトを社内で標準化する手順にまとめています。
- IDの列を足した複製から「全件」シートを作り、空欄と「特になし」の件数を控える
- 利用目的の範囲・学習に使うか・保持と閲覧の3点を、契約画面と公式ページで確かめる
- ラベル5〜7個と1行の定義を指示文に入れる
- 50件を乱数で選び、人が先に分類してからAIと突き合わせる
よくある質問
- 個人情報保護委員会「生成AIサービスの利用に関する注意喚起等」(令和5年6月2日・別添1) https://www.ppc.go.jp/files/pdf/230602_alert_generative_AI_service.pdf(2026年9月21日取得。見出し「(1) 個人情報取扱事業者における注意点」の2項目を全文引用)
- 個人情報の保護に関する法律(平成15年法律第57号)第2条第3項・第16条第2項 https://laws.e-gov.go.jp/law/415AC0000000057(2026年9月21日にe-Gov法令検索で条文を取得。令和8年7月17日施行の改正を反映した版。第16条第2項は定義とただし書きを参照)
- OpenAI「OpenAI におけるエンタープライズプライバシー」 https://openai.com/ja-JP/enterprise-privacy/(ページ上の表示は「更新内容: 2026年1月8日」。2026年9月21日に確認し、「OpenAI によるモデルの学習には、顧客企業のビジネスデータを使うのですか?」と「OpenAI のモデル学習用データの入手先はどこですか?」の回答を引用)
- Google Workspace Help「Generative AI in Google Workspace Privacy Hub」 https://knowledge.workspace.google.com/admin/generative-ai/generative-ai-in-google-workspace-privacy-hub(2026年9月21日に英語版を確認。本文では引用せず、確認先として掲載)
- Anthropic「Is my data used for model training?」 https://privacy.claude.com/en/articles/7996868-is-my-data-used-for-model-training(2026年9月21日に確認。本文では引用せず、確認先として掲載)