- AIの誤りは「たまに起きる不具合」ではありません。不確かなときに「分かりません」と言うより推測した方が評価で得をするという、学習と評価のしくみから生まれます。しくみ側の是正には時間がかかるため、当面は使う側で受け止めるしかありません(編集部の判断)。
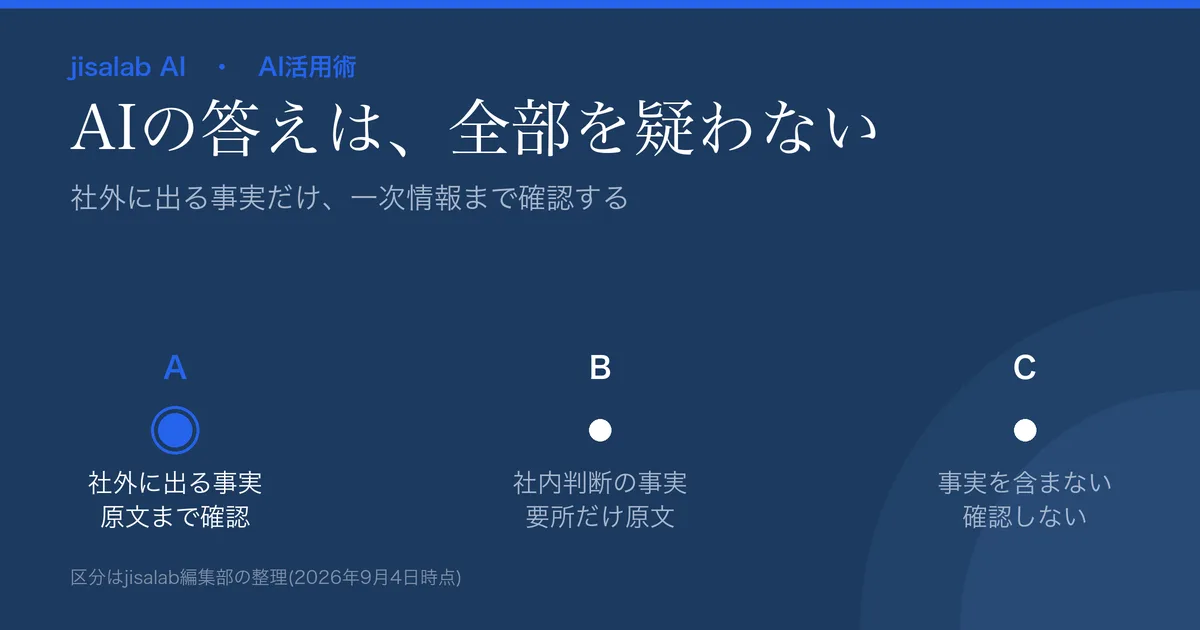
- だから全部を疑うのではなく、出力を3段階に仕分けて、検証の深さを変えるのが現実解です。社外に出る数字・固有名詞・出典だけは、必ず一次情報に当たります。
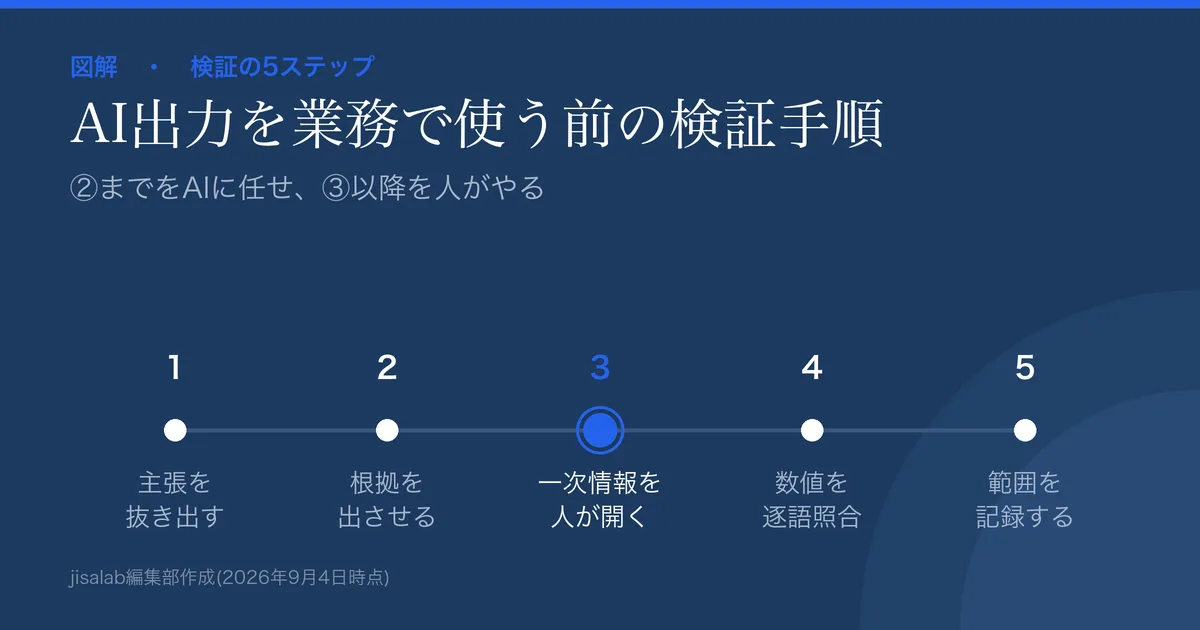
- 検証は「①主張を抜き出す→②根拠を出させる→③一次情報に当たる→④数値と固有名詞を逐語照合→⑤記録する」の5ステップ。AIに出典を出させる機能は便利ですが、出典が出ること自体は正しさの保証ではありません。
生成AIが書いた資料の数字が、後から間違っていると分かった。引用されていた出典を開いたら、そんなページは存在しなかった——AIを業務に入れた組織から、よく聞く相談です。この記事は、AIの出力を業務で使う前に、誤りを止めるための検証手順を解説します。対象は、AIで資料・メール・企画・調査を作っている実務担当者と、その成果物に責任を負う管理職の方です。
前提として、この記事は「AIを使うな」という話ではありません。検証の総量を増やさずに、危ない箇所だけを確実に捕まえる配分を作るのが目的です。全部を人力で確認するなら、そもそもAIを使う意味がなくなります。
最終更新: 2026年9月4日/本文で参照した公式資料・論文・裁判所文書は同日に原文で確認しています。各AIサービスの仕様・機能名は変更されるため、実施前に各公式でご確認ください。
なぜAIは「もっともらしい嘘」をつくのか
まず、相手の性質を正しく知っておく必要があります。AIの誤りは、ランダムなバグではありません。推測が報われる設計になっているために起きるという説明が、研究の形で出ています。
OpenAIの研究者3名(Adam Tauman Kalai氏、Ofir Nachum氏、Edwin Zhang氏)とジョージア工科大学のSantosh S. Vempala氏による論文「Why Language Models Hallucinate」(2025年9月4日投稿・査読前のプレプリント)は、次のように述べています。
“We argue that language models hallucinate because the training and evaluation procedures reward guessing over acknowledging uncertainty”
(編集部訳: 言語モデルが幻覚を起こすのは、学習と評価の手続きが、不確実性を認めることよりも推測することに報酬を与えているからだと私たちは主張する)
同論文は、その理由を試験にたとえて説明しています。正解に1点、空欄や「分かりません」に0点という採点方式では、自信がなくても書いた方が期待得点が上がります。多くのAIベンチマークが正答率で採点されているため、モデルは常に「試験を受けている状態」に置かれ、推測が習慣づけられる、という整理です。
ここから、実務で使える読み方がひとつ出てきます。同論文は、こうした推測(bluff)がどう現れるかを次のように書いています(第1.2節)。
“Bluffs are often overconfident and specific, such as “September 30” rather than “Sometime in autumn” for a question about a date.”
(編集部訳: はったりはしばしば過度に自信があり具体的である。日付を問う質問に対して「秋のいつか」ではなく「9月30日」と答えるように)
ここで取り違えたくないのは、この記述が言っているのは「はったりは具体的な形で出てくる」であって、その逆の「具体的な答えはすべて怪しい」ではないという点です。一次情報から正確に引いた「32.7%」は、むしろ信頼できる数字です。
実務に落とすなら、数字の具体性ではなく、出所を言えるかどうかで分けるのが正しい読み方になります。具体的な数値や日付が出てきたら、まず「それはどこに書かれていますか」と聞き返す。根拠を示せない具体的な数字は、曖昧な表現より危険です。断定の強さが、そのまま読み手の信頼を集めてしまうからです。
同論文には、性質がよく分かる例示が2つ載っています。いずれも統制された実験ではなく、少数回の試行を示したものですが、挙動はよく伝わります。1つ目は、論文の第一著者本人の誕生日を「知っていれば日付だけ答えて」と条件を付けて尋ねた例です。同じ1つのモデル(DeepSeek-V3。2025年5月11日に実施と脚注に明記)に3回尋ねたところ、「03-07」「15-06」「01-01」という3つの異なる日付が返り、いずれも不正解でした(第1章)。知っている場合だけ答えるよう条件を付けても、こうなるという記録です。
2つ目は、同じ著者の博士論文のタイトルを別々の3つのモデルに尋ねた例で、3つとも異なるタイトルと年を答え、どれも正解ではありませんでした(同論文Table 1)。つまり同じAIに聞き直しても、別のAIに聞き直しても、答えは揃いません。誤りは「たまに1つ混じる」のではなく、知識が欠けている領域でそのつど作られると考えた方が実態に近いことが分かります。
この性質は、検索と組み合わせても完全には消えません。同論文は「Discussion and limitations」の節に「Search (and reasoning) are not panaceas.」(検索と推論は万能薬ではない)という小見出しを立て、検索やRAG(検索拡張生成)がハルシネーションを減らすという複数の研究を認めたうえで、「the binary grading system itself still rewards guessing whenever search fails to yield a confident answer」(検索が確信のある答えを返せないときには、二値の採点方式そのものが依然として推測に報酬を与える)と述べています。総務省・経済産業省の「AI事業者ガイドライン」(第1.2版)も脚注で「RAG(検索拡張生成)の活用等により、ハルシネーションの抑制や出力過程・根拠の透明性向上等が期待されている」と書いており、あくまで「抑制」と「期待」です。Anthropicの公式ドキュメントも、対策手法を列挙したうえで最後にこう注記しています。
“Remember, while these techniques significantly reduce hallucinations, they don’t eliminate them entirely. Always validate critical information, especially for high-stakes decisions.”
(編集部訳: これらの手法は幻覚を大幅に減らすが、完全になくすわけではないことを忘れないでほしい。特に重大な意思決定においては、重要な情報を常に検証すること)
ツールを提供している側が「消えない」と明言している以上、検証は運用側の仕事として設計するしかありません。次章から、その配分を決めます。
全部を検証すると仕事が止まる:出力を3段階に仕分ける
AI活用が失敗する典型は、「全部確認しましょう」と決めて、2週間後に誰も確認しなくなるパターンです。負荷が現実的でないルールは守られません。先に「確認しないと決めるもの」を決めるのが、結果的に精度を上げます。
| 区分 | 該当する出力 | 検証の深さ | 目安の時間配分(編集部の推奨値) |
|---|---|---|---|
| A: 外に出る事実 | 提案書・見積の根拠、プレスリリース、契約・法令の説明、統計や市場規模、他社の製品仕様・価格 | 一次情報の原文に当たる。数値・固有名詞・日付を逐語照合 | 作成時間の5割〜同等 |
| B: 社内判断に使う事実 | 社内会議の資料、比較検討のたたき台、要約、議事録の要点 | 出典の有無と鮮度を確認。判断を左右する数字だけ原文に当たる | 作成時間の3〜5割 |
| C: 事実を含まない出力 | 文章の推敲、言い換え、構成案、アイデア出し、書式の整形 | 読んで違和感がないかのみ。事実確認は不要 | ほぼゼロ |
仕分けの基準はシンプルです。「これが間違っていたら、誰かが不利益を被るか」で分けます。社外の相手が判断材料にするならA、社内で議論の入口に使うだけならB、事実を主張していないならCです。ひとつの成果物のなかでAとCが混在するのが普通なので、文書単位ではなく主張単位で仕分けます。
「5割〜同等」と言われてもピンとこないはずなので、区分Aの項目数から積み上げる形で計算してみます。下記の数値はすべて説明用の例です。実際の所要時間は業務によって変わるので、自社で数件を計ってから置き換えてください。
- 営業提案書1本に、社外へ出す数字・固有名詞・出典が12項目あるとする
- 1項目の確認にかかる時間は、出典が示されていれば開いて突き合わせるだけで1〜2分、出典を自分で探すところからなら5〜10分
- 出典あり8項目 × 2分=16分/出典なし4項目 × 8分=32分。合計48分
従来、資料集めから清書まで4時間かかっていた提案書が、AIでの初稿作成1時間+検証48分で約1時間50分になる、という形です。この式の使いどころは、調整すべき変数がどれかが見えることにあります。効くのは検証の丁寧さではなく、「出典なし」の項目数です。次章のプロンプトでAIに出典を出させておけば、8分の項目が2分の項目に変わります。ここを詰めると、検証時間はほぼ半分になります。
逆に、検証を省いて1時間で出す運用は、短縮しているのではなく、誤りが混ざる確率を引き受けているだけです。提案書の数字が1件違っていたときの手戻り(訂正の連絡、信用の低下、再提出)を考えれば、48分は保険料としては安い部類に入ります。区分Cの推敲にまで同じ手間をかけていれば、短縮効果はそのまま消えます。配分こそが成果を決めます。
検証の5ステップ:そのまま使えるプロンプト付き
⓪ 書かせる前に、答える基準を決めておく
①〜⑤は出力された後の手順ですが、その前に打っておける手があります。前章の論文は、原因を「推測が報われる採点方式」と診断したうえで、その処方として採点条件を指示文のなかで明示する方法を挙げています(第4.2節「Explicit confidence targets」)。論文が例として示している文面はこうです。
“Answer only if you are > t confident, since mistakes are penalized t/(1 − t) points, while correct answers receive 1 point, and an answer of “I don’t know” receives 0 points.”
(編集部訳: 確信度が t を超える場合にのみ答えること。誤りには t/(1 − t) 点の罰点が科され、正解は1点、「分かりません」という回答は0点である)
同論文は t の値として0.5(罰点1)、0.75(罰点2)、0.9(罰点9)を挙げています。要するに「外したときの損を先に宣言しておく」やり方です。
ここで誤解しないでいただきたい点があります。論文がこれを求めている相手は、AIを評価するベンチマークの側です。原文は「we propose evaluations explicitly state confidence targets in their instructions」(評価の側が、指示文のなかで確信度の目標を明示することを提案する)とあり、アブストラクトでも処方は「既存ベンチマークの採点方式を修正すること」だと明言されています。論文が一般利用者向けのプロンプト術を推奨しているわけではありません。以下は、その考え方をjisalab編集部が日常業務のプロンプトに翻案したものです。
- これから聞くことに答えるとき、自信が9割に満たない項目は答えないでください。当てずっぽうで書くより、「分かりません」と答える方が高く評価します。答えた項目が誤っていた場合の損失は、答えなかった場合よりはるかに大きいと考えてください。確信がある項目とない項目は、分けて示してください。
このあとのプロンプト例1〜3が書かれた後に誤りを拾う手順であるのに対し、これは書かれる前に推測を抑える指示です。効果を過信はできません(前章のとおり、どの手法も誤りを完全にはなくしません)。それでも確認すべき項目の数そのものを減らせる可能性があるので、区分Aの作業を始める前に一度置いておく価値があります。ここから先が、書かれた後の5ステップです。
① 事実の主張だけを抜き出す
いきなり読み返して確認しようとすると、文章の流れに引きずられて誤りを見落とします。先に「事実を主張している文」だけを箇条書きに落とすと、確認対象が具体的になります。この作業自体はAIに任せられます。
- 以下の文章から、事実を主張している文だけをすべて抜き出し、箇条書きにしてください。意見・提案・推測の文は除きます。各項目に「数値を含む/固有名詞を含む/日付を含む」のタグを付けてください。抜き出した文は、原文のまま一字一句変えないでください。
出てきた箇条書きが、そのまま検証リストになります。ここで数値・固有名詞・日付のタグが付いた項目が、優先して確認すべき対象です。前章のとおり、判断すべきは断定の強さではなく出所を言えるかどうかなので、次のステップで根拠を要求します。
② 根拠を出させる。出せない主張は落とさせる
次に、抜き出した各主張について根拠を出させます。ここで重要なのは、「出典を書いて」ではなく「根拠が見つからない主張は消して」と指示することです。Anthropicの公式ドキュメントは、この手法を次のように説明しています。
“Make Claude’s response auditable by having it cite quotes and sources for each of its claims. You can also have Claude verify each claim by finding a supporting quote after it generates a response. If it can’t find a quote, it must retract the claim.”
(編集部訳: 各主張について引用と出典を示させることで、応答を検証可能にする。応答の生成後に、各主張を裏づける引用を見つけさせて検証させることもできる。引用が見つからない場合は、その主張を撤回させる)
同ドキュメントは基本手法として、ほかに2つを挙げています。1つは「Allow Claude to say “I don’t know”」(分からないと言うことを明示的に許可する)で、これについて「この単純な手法が誤情報を劇的に減らしうる」と評価しています。「知らないと言ってよい」と明示するだけで挙動が変わるのは、前章の「推測が報われる」構造のちょうど裏返しです。もう1つは「Use direct quotes for factual grounding」(事実の裏づけに直接引用を使う)で、こちらは2万トークンを超えるような長い文書を扱う作業について、先に一言一句そのままの引用を抜き出させてから本題に入るよう勧めています(原文は “For tasks involving long documents (>20k tokens)”)。短いメールの校正にまで求められている手法ではありません。
- 上の各主張について、添付した資料の中から、その主張を裏づける一言一句そのままの引用を1つずつ示してください。引用が見つからない主張は、推測で補わずに「根拠なし」と明記してください。資料に書かれていない一般知識は使わないでください。分からない場合は「分かりません」と答えてください。
この指示の効きどころは、「資料に書かれていない一般知識は使わない」の一文です。Anthropicの公式ドキュメントも独立した手法として「External knowledge restriction」を挙げ、提供した文書の情報だけを使い、一般知識を使わないよう明示的に指示することを推奨しています。この一文がないと、AIは資料と記憶を混ぜて答えます。
ただし、実務でよく起きる事故は「資料を渡さずに書かせた」ケースです。冒頭に挙げた市場規模や存在しない出典は、たいてい手元に資料がないまま質問した結果として出てきます。この場合、突き合わせる対象そのものがないので、プロンプト例2は使えません。代わりに次を使います。
- 上の各主張について、根拠となる出典を示してください。ただしURLや出典名を推測で作らないでください。出典を確実に示せない主張は、書き直さずに「根拠を示せない」とだけ答えてください。あわせて、その主張がいつ時点の情報か、日本の制度・慣行にそのまま当てはまるかも、分かる範囲で答えてください。分からない項目は「分かりません」と答えてください。
ここで返ってきた「根拠を示せない」項目が、そのまま検索して裏を取るべきリストになります。逆に言えば、資料を渡さずに書かせた文章は、区分Aに使うならほぼ全項目が自力での裏取り対象になると考えてください。前章の試算で「出典なし1項目=8分」としたのは、この状態を指しています。最初に資料を渡しておく方が、結局は速く終わります。
③ 出てきた根拠を、人が一次情報で開く
ここからは人の仕事です。AIが示した引用やURLを、実際に開いて存在を確かめます。手を抜きたくなる工程ですが、ここを省略すると前の2ステップも無意味になります。存在しない出典が生成されている場合、AIに聞き返しても「実在する」と答えることがあるからです。
これは想像ではありません。後述するニューヨーク州南部地区連邦地方裁判所の制裁決定には、実際の記録が残っています。弁護士がChatGPTに対して「Is Varghese a real case」(Vargheseは実在する判例か)、「Are the other cases you provided fake」(提供された他の判例は偽物か)と質問したところ、ChatGPTは提供したのはWestlaw・LexisNexis・Federal Reporterで見つけられる「real」な典拠だと回答した——そのスマートフォンのスクリーンショットが、決定に付属資料として添付されています(同決定の事実認定45項)。実在しない判例について、実在すると答えた記録です。同じAIへの問い直しは、検証の代わりになりません。
確認の順番は次のとおりです。判断材料になる順に並べています。
- その出典が実在するか: URLを開く。開けない、別内容に飛ぶなら、その主張は落とす
- 発信元が一次情報か: 官公庁・企業の公式・法令原文・学術論文か。まとめ記事や個人の解説は根拠に使わない
- 引用文が原文と一致するか: 検索(Ctrl+F)で本文中の該当箇所を探し、一字一句を突き合わせる
- いつの情報か: 公表日・更新日を見る。価格や制度は1年で変わる
- 条件が付いていないか: 「ただし」「〜の場合を除き」以下が落ちていないかを確認する
5番目が最も抜けやすい落とし穴です。要約の過程で例外規定や適用条件だけが落ちると、無条件のルールに読める文章が出来上がり、結論が逆になります。法令・規約・料金体系では、条件節こそが意味の中心だからです。この型は後の章でもう一度扱います。長い資料を扱うときの読み方は長文資料・PDFをAIで速く読む手順で解説しています。
④ 数値・固有名詞・日付を逐語で照合する
意味が合っていても、数字が違えば資料としては失格です。この工程は読むのではなく、突き合わせる作業として分けてください。読むと脳が補正してしまいます。
- 桁と単位: 億と兆、千と万、%とポイント、ドルと円。翻訳を挟むと入れ替わりやすい
- 年と年度: 「2025年」と「2025年度」は範囲が違う。和暦と西暦の変換も要確認
- 固有名詞: 会社名の法人格(株式会社/一般社団法人)、旧社名・改称、似た名前の別サービス
- 肩書と所属: 過去の肩書が現在形で書かれていないか
- 相対表現: 「昨年」「最新の」は、いつ時点かで意味が変わる。日付に置き換える
⑤ 何を確認し、何を確認しなかったかを記録する
最後に、確認した範囲を1〜2行残します。「区分Aの5項目を公式資料で確認。市場規模の推計値は出典が見つからず本文から削除」といった粒度で十分です。手間に見えますが、これがないと後から問題が起きたときに、誰も範囲を再現できません。社内で運用ルールを作る段階に進むなら、生成AIの社内利用ルールを作る手順で、この記録をどこに残すかまで含めて整理しています。
「出典が出る機能」は、どこまで信じてよいか
近年のAIサービスは、回答に出典リンクを添える機能を備えています。便利ですが、何が表示されているのかを誤解したまま使うと、確認したつもりで通してしまいます。提供元の公式説明を読むと、位置づけがはっきりします。
Googleの公式ヘルプ「View related sources from Gemini Apps」は、この機能を次のように説明しています。
“Sometimes Gemini Apps show you sources and related content within and below its response.” / “Not all responses include related links or sources.”
(編集部訳: Gemini Appsは、応答の中や下に出典や関連コンテンツを表示することがあります/すべての応答に関連リンクや出典が含まれるわけではありません)
注目すべきは、“sources and related content”(出典と関連コンテンツ)という並びと、“Sometimes”(〜することがある)という限定です。同ヘルプはリンクの中身についても、「応答の一部に関連するコンテンツ」を含みうると説明しています。つまり表示されたリンクは、必ずしも「その文を生成した根拠」ではありません。同ヘルプは、出典ボタンが表示されない場合について「その応答についてリンクが提供されなかった」だけである、とも書いています。
| 見えている状態 | 意味すること | 実務での扱い |
|---|---|---|
| 出典リンクが付いている | 関連する情報源が示された。根拠そのものとは限らない | 開いて、該当する記述が本当にあるか確認する |
| 出典リンクが付いていない | その回答にリンクが提供されなかったという事実のみ | 誤りとも正しいとも判断できない。区分Aなら自分で探す |
| 本文中に脚注番号がある | 文と情報源が対応づけられている | 数値・固有名詞は対応先の原文で逐語照合する |
| 検索して答えたと表示される | 検索結果を参照した。要約時の取り違えは別問題 | 要約の過程で条件節が落ちていないかを見る |
出典を出すタイプのAI検索を業務で使うなら、Perplexity Proは使う価値があるかで有料版と無料版・汎用AIの違いを比較しています。検索そのものの使い方はAI検索で仕事のリサーチを速くするで解説しています。ChatGPTやGeminiなど個別サービスの機能・料金は、各レビューをご覧ください。
よく出る誤りの型を6つ覚えておく
検証を速くする一番の方法は、「どこで間違えやすいか」を先に知っておくことです。以下は出典に基づく分類ではなく、編集部が記事制作で繰り返し出会った型を整理したものです。
- 存在しない出典・URL: 本物らしい書式のURL、実在の官庁名と架空の資料名の組み合わせ。開けば分かる
- 制度と年度の取り違え: 改正前の内容を現行として説明する、旧制度の名称を使う、施行日と公布日を混同する
- 桁と単位のずれ: 億と兆、%とポイント、月額と年額、税込と税別。海外の情報を訳すと起きやすい
- 似た固有名詞の取り違え: 同名の別サービス、旧社名、親会社と製品名の混同
- 古い価格・プラン名: SaaSの料金は改定が多い。学習時点の価格が現在形で出る
- 条件節の脱落: 「ただし」「〜を除く」「〜の場合に限り」が落ち、無条件のルールに読める
この6つのうち、実害が大きいのは最後の「条件節の脱落」です。ほかの5つは出典を開けば分かりますが、条件節の脱落は文章として自然に読めてしまい、原文と突き合わせない限り気づけません。法令・補助金の要件・利用規約・保険の条件など、「例外があること」が本質である文書が該当します。
職種別に、特に気をつける箇所は次のように分かれます。
- 営業・企画: 提案書に載せる市場規模、他社の価格、導入実績。相手が判断材料にするため区分Aです。作り方はAIで提案書・営業資料を速く作る手順を参照してください
- 管理部門・情シス: 制度改正の説明、規程のひな形、セキュリティ要件。条件節の脱落が直撃します
- マーケ・広報: 統計、比較表現、体験談。社外に出るため、出典の年次まで確認が要ります
日本の読者にとっての意味
日本でAIを業務に使う場合、日本語で読んでいると見落としやすい論点がいくつかあります。第一に、日本固有の情報ほど、確認せずに使うのが危ういという実務上の判断です。制度・法令・補助金・業界慣行は日本独自で、しかも改正が頻繁です。英語圏の一般論としては筋が通っていても、日本の制度に当てはめると成り立たない説明が生成されることがあります。日本語で質問したからといって、日本の制度を前提に答えているとは限りません。ここは編集部の判断ですが、「日本の制度・法令の話をさせたときは、区分Aに寄せる」という運用にしておくと安全側に倒せます。
第二に、国の指針が「確認したうえで使う」ことを利用者側の役割として明記していることです。日本では「人工知能関連技術の研究開発及び活用の推進に関する法律」(令和7年法律第53号)が2025年6月に公布され、9月に全面施行されています(同ガイドライン本編の記載による)。そのうえで、総務省・経済産業省の「AI事業者ガイドライン」(第1.2版・令和8年3月31日)は、AI利用者に関する事項の「U-2)i. 安全を考慮した適正利用」で、「AI の出力について精度及びリスクの程度を理解し、様々なリスク要因を確認した上で利用する」ことを挙げています。なお、これと並ぶ「U-3)i. 入力データ又はプロンプトに含まれるバイアスへの配慮」は「3)公平性」に紐づく項目で、事実の正確性を検証せよという規定ではありませんが、そこでも「責任をもって AI 出力結果の事業利用判断を行う」ことが求められています。出力をそのまま使わず、事業判断として引き受けるという姿勢は共通しています。同ガイドラインは第5部の冒頭で、「人間の判断を介在させることにより、人間の尊厳及び自律を守りながら予期せぬ事故を防ぐことも可能となる」とも述べています。
ここで押さえておきたいのは、このガイドライン自体の位置づけです。同ガイドラインは、細かな行為義務を規定するルールベースの規制はイノベーションを阻害する可能性があるといった指摘を踏まえ、関係者による自主的な取組を促す「非拘束的なソフトロー」として作成したと自ら述べています。違反すれば罰則、という性質のものではありません。裏を返せば、何をどこまで確認するかは各社が自分で決めるしかないということでもあります。だからこそ、この記事のA・B・Cのような区分を、先に自社で決めておく意味があります。ガイドラインは、その社内ルールを通すときの根拠として使えます。
第三に、責任は使った側に残るという点です。米国の事例ですが、ニューヨーク州南部地区連邦地方裁判所は2023年6月22日、実在しない判例をChatGPTで作成して提出した弁護士らに対する制裁決定を出しました。Castel判事は決定の冒頭でこう述べています。
“Technological advances are commonplace and there is nothing inherently improper about using a reliable artificial intelligence tool for assistance. But existing rules impose a gatekeeping role on attorneys to ensure the accuracy of their filings.”
(編集部訳: 技術の進歩はありふれたことであり、信頼できる人工知能ツールを支援に使うこと自体に本質的な不適切さはない。しかし既存のルールは、提出書類の正確性を確保するゲートキーパーとしての役割を弁護士に課している)
ここでいう「既存のルール」を、決定は連邦民事訴訟規則第11条(Rule 11, Fed. R. Civ. P.)として示しています。決定が問題としたのは、弁護士らが裁判所の命令によって判例の存在に疑義が呈された後も、偽の判例を主張し続けたことでした。科された制裁は、当事者および名前を騙られた各裁判官への書面の送付、その送付書面の写しの裁判所への提出、そして5,000ドルの制裁金です。決定はこの金額について、処罰や賠償としてではなく抑止の目的を進めるためのものだと明記しています。日本の制度とは前提が異なるため、そのまま当てはめることはできません。それでも「AIを使ったこと」ではなく「確認する役割を放棄したこと」が問われたという構図は、日本の実務でもそのまま通用します。社外に出す文書の正確性は、AIではなく発信者の責任として残ります。
なお、本記事は業務手順の一般的な解説であり、法令やガイドラインの解釈を確定させるものではありません。個別の適法性の判断は、自社の規程および弁護士等の専門家にご確認ください。
次に取るべき行動
- □ 自部署でAIを使っている成果物を書き出し、A(社外に出る事実)/B(社内判断)/C(事実を含まない)に仕分ける
- □ 区分Aは「一次情報の原文に当たる」を必須、区分Bは「出典と鮮度の確認+判断を左右する数字だけ原文に当たる」、区分Cは事実確認をしない、と明文化する
- □ 4つのプロンプト例(⓪〜③)を社内の共有ドキュメントに置き、コピーして使える状態にする
- □ 使っているAIサービスの出典表示について、公式ヘルプで「何が表示されているのか」を確認する
- □ 数値・固有名詞・日付は、読むのではなく突き合わせる工程として分ける
- □ 法令・規約・要件を要約させたときは、必ず原文の条件節(ただし書き)を開いて確認する
- □ 確認した範囲と、確認できずに削除した主張を1〜2行で記録する運用にする
- □ 誤りが見つかったら、担当者を責めずに「どの区分で漏れたか」を記録し、区分の基準を直す
よくある質問(FAQ)
AIに「この情報は正しいですか?」と聞き返せば確認になりますか?
なりません。同じモデルに聞き返しても、独立した検証にはならないためです(実例は本文の「③ 出てきた根拠を、人が一次情報で開く」を参照)。ただし、聞き方を変えれば有用な使い方はあります。Anthropicの公式ドキュメントは高度な手法として「Best-of-N verification」を挙げ、同じプロンプトを複数回実行して出力を比較し、出力間の不一致があれば幻覚の兆候になりうるとしています。同じ質問を3回投げて答えが揺れる項目は、要確認の印になります。とはいえ、揺れなかったからといって正しい保証にはなりません。最終的な確認は一次情報で行ってください。
検証にかける時間が惜しいのですが、削るならどこですか?
区分Cの事実確認と、区分Bの「判断を左右しない数字」から削ってください。逆に、絶対に削ってはいけないのは区分Aの出典の実在確認です。ここは開くだけなので1件あたり十数秒で終わり、それでいて最も実害の大きい誤りを止められます。費用対効果が突出して高い工程です。時間が足りないときは、確認の深さを下げるのではなく、区分Aに載せる項目そのものを減らす(社外資料に載せる数字を絞る)方向で調整してください。確認できない数字は、載せないのが最も安全です。
検索できるAIを使えば、誤りは減りますか?
減りますが、なくなりません。「AI事業者ガイドライン」も、RAG(検索拡張生成)などの活用によってハルシネーションの抑制が「期待されている」と書いており、解決したとは書いていません。検索を併用する場合の誤りは、種類が変わります。事実の捏造は減る一方で、参照先の取り違え、古いページの参照、要約時の条件節の脱落が増えます。つまり「出典が付いているのに内容が違う」形になり、パッと見では気づきにくくなります。検索併用型を使うときこそ、リンクを開いて該当箇所を突き合わせる工程を省かないでください。
社内でこの手順を定着させるには、どこから始めるべきですか?
区分Aの定義を1行で決めるところから始めてください。「社外に出す文書に載せる数字・固有名詞・出典」といった粒度で十分です。全社ルールを作ろうとすると合意形成に時間がかかるため、まず1部署・1業務で運用し、そこで見つかった誤りの型を持ち寄る方が早く回ります。定着の鍵は、誤りが見つかったときに個人を責めないことです。責める運用にすると、AIを使ったこと自体が隠されるようになり、検証の機会そのものが失われます。
あわせて読みたい
AIで作った比較表を、出典と照合して稟議に使える形にするなら → AIで比較検討の下調べを根拠つきで進める手順
この検証手順を社内ルールに落とし込むなら → 生成AIの社内利用ルールを作る手順
出典・参考
- Adam Tauman Kalai(OpenAI)、Santosh S. Vempala(Georgia Tech)、Ofir Nachum(OpenAI)、Edwin Zhang(OpenAI)「Why Language Models Hallucinate」(arXiv:2509.04664v1、2025年9月4日投稿・査読前のプレプリント)より、アブストラクト、第1章冒頭の誕生日の例およびTable 1、第1.2節(Why hallucinations survive post-training)、第4.1節およびTable 2、第4.2節(Explicit confidence targets)、第5節(Discussion and limitations)の「Search (and reasoning) are not panaceas.」|arXiv(2026年9月4日にPDF原文で確認)
- Anthropic「Reduce hallucinations」(Claude 公式ドキュメント)より、Basic hallucination minimization strategies の3項目、Advanced techniques の Best-of-N verification および External knowledge restriction、末尾の注記|Anthropic Docs(2026年9月4日に原文で確認)
- 総務省・経済産業省「AI事業者ガイドライン」(第1.2版、令和8年3月31日)より、第5部 AI利用者に関する事項の冒頭、U-2)i. 安全を考慮した適正利用、U-3)i. 入力データ又はプロンプトに含まれるバイアスへの配慮、および脚注27|経済産業省(2026年9月4日にPDF原文で確認)
- Google「View related sources from Gemini Apps」(Gemini Apps ヘルプ)|Gemini Apps Help(2026年9月4日に原文で確認)
- United States District Court, Southern District of New York「Mata v. Avianca, Inc.」22-cv-1461 (PKC)、Opinion and Order on Sanctions(2023年6月22日、Castel判事)より、冒頭段落、事実認定45項、および結論部d項|決定原文PDF(CourtListener)(2026年9月4日に原文で確認)
- 本記事は業務手順の一般的な解説であり、法令・ガイドラインの解釈を確定させるものではありません。個別の適法性の判断は弁護士等の専門家にご確認ください。各AIサービスの機能・仕様は変更されるため、実施前に各公式でご確認ください。
本記事に登場する製品名・ロゴは各社の商標または登録商標です。掲載の図解はjisalab編集部が作成したものです。英文の資料は原文と編集部訳を併記しています。時間・金額の試算は説明用の例であり、自社の実額に置き換えて判断してください。